

Previsione della classificazione del cancro al seno basata sull'apprendimento automatico
Sep 12, 2023
Il cancro al seno è il tipo di cancro più comune e mortale al mondo. Basato su algoritmi di apprendimento automatico come XGBoost, random forest, regressione logistica e K-nearest neighbor, questo documento stabilisce diversi modelli per classificare e prevedere il cancro al seno, per fornire un riferimento per la diagnosi precoce del cancro al seno. Il ricordo indica la probabilità di rilevare cellule tumorali nella diagnosi medica, che è di grande importanza per la classificazione del cancro al seno, quindi questo articolo prende il ricordo come indice di valutazione primario e considera la precisione, l'accuratezza e la valutazione del punteggio F1- indicatori per valutare e confrontare l’effetto di previsione di ciascun modello. Per eliminare l'influenza dei diversi concetti dimensionali sull'effetto del modello, i dati sono standardizzati.
L'algoritmo del vicino più vicino K è uno degli algoritmi più basilari nel campo dell'apprendimento automatico. La sua idea principale è trovare i campioni K più vicini al campione target e quindi prevedere l'etichetta del campione target in base alle etichette di questi campioni K. Nella vita quotidiana umana, spesso utilizziamo metodi simili per prendere decisioni. Ad esempio, quando affrontiamo un determinato problema, ricordiamo situazioni simili che abbiamo incontrato in precedenza, quindi cerchiamo le situazioni più simili e prendiamo decisioni in base ai loro risultati. Sviluppare soluzioni. Pertanto, l'algoritmo del vicino più vicino K è strettamente correlato alla memoria umana.
Prima di tutto, l'algoritmo del vicino più vicino K richiede un gran numero di set di addestramento per apprendere e stabilire una struttura dati del grafo del vicino più vicino. Allo stesso modo, gli esseri umani hanno bisogno di sperimentare costantemente varie cose e di immagazzinare queste esperienze nella memoria. Solo accumulando una grande quantità di esperienza e conoscenza possiamo prendere decisioni e giudicare in modo più accurato.
In secondo luogo, l’algoritmo del vicino più vicino K enfatizza l’impatto della somiglianza sulla previsione. Allo stesso modo, quando prendono decisioni, gli esseri umani spesso considerano prima le esperienze passate e cercano di trovare esperienze simili alla situazione attuale come riferimento. Questo processo di ricerca di somiglianze è anche una delle caratteristiche importanti della memoria.
Infine, nell'algoritmo del vicino più vicino K, il valore di K ha un grande impatto sui risultati della previsione. Valori K diversi porteranno a risultati di previsione diversi. Allo stesso modo, quando gli esseri umani ricordano le esperienze passate, devono scegliere diversi punti di riferimento e metodi a seconda della situazione attuale. Questa flessibilità e adattabilità sono anche una caratteristica importante della memoria. Si può vedere che dobbiamo migliorare la nostra memoria. La Cistanche deserticola può migliorare significativamente la memoria perché la Cistanche deserticola è un materiale medicinale tradizionale cinese con molti effetti unici, uno dei quali è quello di migliorare la memoria. L'efficacia della carne macinata deriva dai vari principi attivi che contiene, tra cui acidi, polisaccaridi, flavonoidi, ecc. Questi ingredienti possono favorire la salute del cervello in vari modi.

Fare clic su Conosci per migliorare la memoria a breve termine
Per trovare il sottoinsieme ottimale e migliorare la precisione del modello, 15 caratteristiche sono state selezionate come input per il modello attraverso il test di correlazione di Pearson. Il modello del vicino più vicino K utilizza il metodo di convalida incrociata per selezionare il valore k ottimale utilizzando il richiamo come indice di valutazione. Per il problema dello squilibrio del campione positivo e negativo, il metodo di campionamento gerarchico viene utilizzato per estrarre il set di addestramento e il set di test proporzionalmente in base alle diverse categorie. I risultati sperimentali mostrano che con diverse divisioni del set di dati (8: 2 e 7: 3), l'effetto di previsione dello stesso modello avrà cambiamenti diversi. L'analisi comparativa mostra che il modello XGBoost stabilito in questo documento (che divide il set di training e il set di test per 8: 2) ha effetti migliori e il suo ricordo, precisione, accuratezza e punteggio F1- sono 1.{{ 11}}, 0.960, 0.974 e 0.980, rispettivamente.
1. Introduzione
Negli ultimi dieci anni, l’incidenza del cancro al seno in Cina è aumentata del 47%, e l’incidenza aumenta di anno in anno e l’incidenza del cancro al seno è gradualmente inferiore [1]. La patogenesi del cancro al seno è correlata agli ormoni personali, alla storia familiare, al matrimonio e alla storia della gravidanza [2]. Il cancro al seno non è facile da individuare nella fase iniziale e ha le caratteristiche di un’età di esordio precoce ma di una presentazione tardiva [3, 4]. Attualmente, la diagnosi principale del cancro al seno si basa su tre metodi: citologia puntura [5], ecografia [6] e mammografia a raggi X [7]. Se una paziente viene diagnosticata precocemente con un cancro al seno, maggiori sono le probabilità di guarigione e migliore è la prognosi. Pertanto, per la prevenzione e l’individuazione tempestiva del cancro al seno sono estremamente necessari esami regolari e una diagnosi precoce.
In campo medico, la creazione di modelli attraverso metodi di apprendimento automatico può aiutare i medici a migliorare il tasso di rilevamento del cancro, per raggiungere l’obiettivo della diagnosi precoce e del trattamento precoce. I metodi di apprendimento automatico hanno prodotto buoni risultati nella diagnosi del cancro [8, 9]. Wu et al. [10] hanno osservato la morfologia cellulare al microscopio e hanno scoperto che c'erano evidenti differenze tra le cellule del cancro al seno e i normali parametri delle cellule sane. Questa scoperta fornisce una base teorica per molti studi. Sebbene esistano molti metodi di apprendimento automatico attualmente applicati alla classificazione delle cellule del cancro al seno, nessun singolo algoritmo può essere applicato a tutti i problemi. Ogni tipo di algoritmo di machine learning ha le sue aree di competenza, quindi la scelta dell'algoritmo è diversa a seconda degli scenari.
Shen et al. [11] hanno utilizzato il modello XGBoost per classificare e prevedere il cancro al seno e la precisione ha raggiunto il 97,86% e il ricordo ha raggiunto il 95,83%. Deng et al. [12] hanno utilizzato l'algoritmo XGBoost per classificare e prevedere il cancro al seno con un'accuratezza di 0.96 e un ricordo di 0.97. Monirujjaman Khan et al. [13] hanno utilizzato più modelli di machine learning per identificare il cancro al seno e la foresta casuale, l'albero decisionale, il vicino più vicino K e la regressione logistica erano gli algoritmi con il punteggio F1- più alto, 96%, 95%, 90%, e 98%, rispettivamente. Bhardwaj et al. [14] hanno utilizzato il percettrone multistrato (MLP), il K-vicino più vicino (KNN), l'algoritmo genetico (GP) e la foresta casuale (RF) per classificare le cellule del cancro al seno benigne e maligne e i risultati sperimentali hanno mostrato che il classificatore ottimale era RF con una precisione di classificazione del 96,24%. Dong e Ma [15] hanno studiato i possibili marcatori del cancro al seno triplo negativo e sono stati utilizzati algoritmi di apprendimento automatico per prevedere se le persone avevano un cancro al seno triplo negativo. I risultati mostrano che la precisione del modello di previsione della classificazione della Support Vector Machine (SVM) raggiunge il 97,8%.
Per migliorare l'accuratezza dei metodi di identificazione del cancro al seno e migliorare gli algoritmi di apprendimento automatico, Wang et al. [16] hanno proposto un modello di apprendimento dell'insieme AUC ponderato basato su SVM per la diagnosi del cancro al seno, utilizzando C-SVM e V-SVM con 6 funzioni kernel per aumentare la diversità del set di modelli di base e confrontando diversi risultati decisionali con l'Area Integration (WAUCE ) modello sotto la curva caratteristica di lavoro di ricezione ponderata. I risultati mostrano che sul set di dati piccolo, la struttura WAUCE proposta riduce la varianza dell'accuratezza diagnostica fino al 69,23% e migliora l'accuratezza del 0,94%. Zheng et al. [17] hanno testato il set di dati del Wisconsin Breast Cancer (WDBC) in base alle medie K e l'algoritmo ibrido di supporto della macchina vettoriale estrae le caratteristiche del tumore e diagnostica il cancro al seno e i risultati mostrano che l'algoritmo ibrido migliora la precisione al 97,38%. Jia et al. [18] hanno proposto un nuovo algoritmo di ottimizzazione della popolazione, il Whale Optimization Algorithm (WOA), che regola in modo intelligente i parametri del modello SVM, e i risultati sperimentali mostrano che le prestazioni del modello WOA-SVM sono significativamente migliori di quelle del modello tradizionale modello di riconoscimento del cancro al seno, con una precisione del 97,5%.
Per risolvere il problema dell’adattamento eccessivo delle tecniche di apprendimento automatico nella classificazione del cancro al seno, Singh et al. [19] hanno proposto una rete neurale artificiale funzionalmente connessa (FLANN) e hanno scoperto sperimentalmente che il modello ha un'elevata precisione per la diagnosi precoce del cancro al seno. Mahesh et al. [20] propongono una tecnica XGBoost ensemble di previsione del cancro al seno basata su modelli di caratteristiche noti, utilizzando prima la tecnologia di sovracampionamento delle minoranze sintetiche (SMOTE) per gestire lo squilibrio dei dati e i problemi di rumore e quindi utilizzando rispettivamente il classificatore di Bayes, il classificatore dell'albero decisionale e la foresta casuale , combinato con XGBoost e classificando i dati. Secondo l’analisi sperimentale, il classificatore d’insieme XGBoost-Random Forest ha un tasso di precisione del 98,20% nella diagnosi precoce del cancro al seno.
Basato su XGBoost, foresta casuale, regressione logistica, K-vicino più vicino e altri metodi di apprendimento automatico, questo documento stabilisce diversi modelli per classificare e prevedere il cancro al seno, che forniscono un riferimento per la diagnosi precoce del cancro al seno. Quando la maggior parte degli studi applica modelli di machine learning alla diagnosi delle cellule del cancro al seno, si concentra sull'utilizzo della precisione, dell'accuratezza e del punteggio F1-del modello come indicatori per valutare la qualità del modello, ignorando il significato diagnostico medico di il richiamo del modello, che indica la proporzione di cellule maligne di cancro al seno previste, e maggiore è il richiamo, maggiore è la probabilità che vengano previste cellule maligne nelle cellule di cancro al seno. Pertanto, questo articolo considera il ricordo come indice primario e considera precisione, accuratezza e punteggio F1-per valutare il modello utilizzato.
Nel processo di modellazione, la preelaborazione dei dati è una parte molto importante e l'effetto del modello predittivo è diverso a seconda del metodo di elaborazione. Per eliminare l'influenza dei diversi concetti dimensionali sull'effetto del modello, i dati vengono standardizzati. Per trovare il sottoinsieme ottimale e migliorare l'accuratezza del modello, la selezione delle caratteristiche è stata effettuata in base al coefficiente di correlazione di Pearson tra la variabile della caratteristica e la variabile target. Per il problema dello squilibrio del campione positivo e negativo, il metodo di campionamento gerarchico viene utilizzato per estrarre il set di addestramento e il set di test proporzionalmente in base alle diverse categorie. Considerando che l'effetto di previsione dei modelli di apprendimento automatico varia in base alle diverse divisioni del set di dati, questo documento utilizzerà diverse divisioni del set di dati (8: 2 e 7: 3) come due serie di esperimenti per osservare l'effetto di previsione del modello stabilito in questo documento.
2. Preelaborazione dei dati
2.1. Introduzione ai dati. Il set di dati utilizzato in questo articolo sono i dati sul cancro al seno nel set di dati UCI, forniti dal famoso Dr. William del Clinical Medicine Research Institute dell'Università del Wisconsin [21]. Le caratteristiche vengono calcolate da un'immagine digitalizzata di un'agoaspirato (FNA) di una massa mammaria. Descrivono le caratteristiche dei nuclei cellulari presenti nell'immagine. Il set di dati conteneva 569 campioni sperimentali, inclusi 357 campioni benigni e 212 campioni maligni di cancro al seno. Per le cellule estratte da ciascun oggetto sperimentale, vengono raccolte principalmente le seguenti dieci caratteristiche del suo nucleo: raggio (media della distanza dal centro ai punti sul perimetro), perimetro, levigatezza (variazione locale delle lunghezze del raggio), area, compattezza ( perimetro ∗ ∗ 2/area-1.0), concavità (gravità delle porzioni concave del contorno), simmetria, tessitura (deviazione standard dei valori della scala di grigi), punti concavi (numero di porzioni concave del contorno) e la dimensione_frattale ("approssimazione della linea di costa"-1). La media, l'errore standard e il "peggiore" o il più grande (media dei tre valori maggiori) di queste caratteristiche sono stati calcolati per ciascuna immagine, ottenendo 30 caratteristiche. L'etichetta di classificazione rappresenta il tipo di cancro al seno. Pertanto, il set di dati del campione contiene un totale di 30 caratteristiche e una caratteristica dell'etichetta campione (maligna e benigna).
2.2. Standardizzazione dei dati.
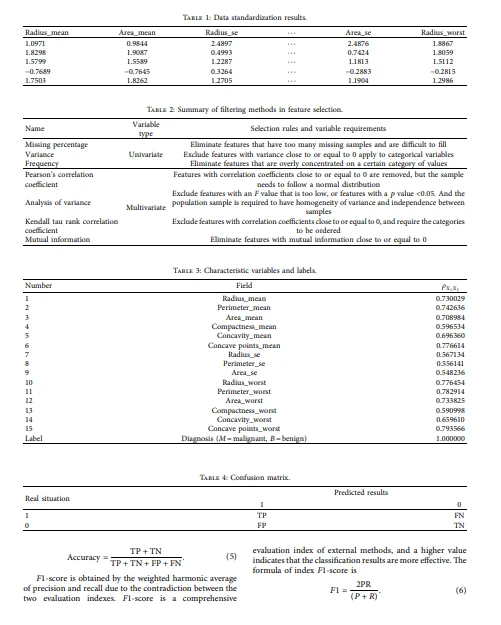
Osservando l'intervallo di valori di ciascuna caratteristica, si riscontra che i valori dei dati delle diverse caratteristiche differiscono notevolmente. In alcuni modelli, dimensioni diverse hanno una grande influenza sull’effetto di previsione. Ad esempio, l'algoritmo k-nearest neighbor basato sulla divisione della distanza deve mantenere coerente la dimensione dei dati, quindi i dati devono essere standardizzati prima della modellazione. Tuttavia, alcuni modelli sono meno influenzati dalla dimensionalità, come l’algoritmo della foresta casuale. Per rendere comparativo l’esperimento, i dati di diversi modelli vengono trattati allo stesso modo.
Per problemi con diverse dimensioni dei dati campione, i metodi di elaborazione adimensionale comunemente utilizzati includono la standardizzazione dei dati, mentre i metodi di standardizzazione dei dati includono la standardizzazione Min-max e la standardizzazione del punteggio Z. Tra questi, quando i dati utilizzati presentano valori anomali al di fuori dell'intervallo di valori, o i valori massimo e minimo di alcuni indicatori sono sconosciuti, è possibile utilizzare la standardizzazione del punteggio Z.

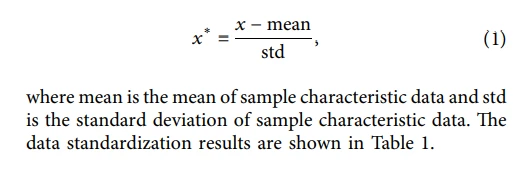
In questo articolo, in base alle caratteristiche del set di dati sul cancro al seno del WDBC, è stata selezionata la standardizzazione del punteggio Z per elaborare i dati. I dati elaborati dalla standardizzazione del punteggio Z [22] seguono una distribuzione normale standard, ovvero la media è 0 e la varianza è 1. La formula per la standardizzazione del punteggio Z è la seguente:
2.3. Selezione delle funzionalità. Essendo una parte importante del processo di preelaborazione dei dati, la selezione delle funzionalità consiste nel trovare il sottoinsieme ottimale. La selezione delle funzionalità può ridurre le funzionalità ridondanti e inutili per migliorare l'accuratezza del modello. Il metodo di selezione delle funzionalità è generalmente suddiviso in metodo di pensiero eccessivo, metodo di incapsulamento e metodo di incorporamento. Il metodo di filtraggio può essere indipendente dall'algoritmo utilizzato più avanti nello studio e ha un'elevata efficienza computazionale e una forte capacità di generalizzazione [23], quindi il metodo di selezione delle caratteristiche in questo documento utilizza il metodo di filtro e il riepilogo generale del metodo nel metodo di filtraggio è mostrato nella tabella 2.
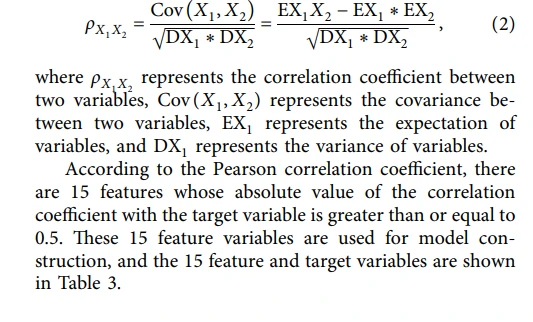
I dati sul cancro al seno dopo la normalizzazione media 0 soddisfano i requisiti del test del coefficiente di correlazione di Pearson nel metodo di filtraggio; quindi in questo articolo, il coefficiente di correlazione di Pearson [24] viene utilizzato per testare la correlazione tra ciascuna caratteristica e la variabile target. La formula del coefficiente di correlazione di Pearson è la seguente:
3. Costruzione del modello
In questo articolo, le categorie di cancro al seno sono previste rispettivamente sulla base di XGBoost, foresta casuale, regressione logistica e modello K-nearest Neighbor. Il cancro al seno maligno è considerato un campione positivo, mentre il cancro al seno benigno è considerato un campione negativo
Per risolvere il problema dello squilibrio del campione, questo articolo utilizza un metodo di campionamento stratificato [25] per estrarre il set di addestramento e il set di test in proporzione a tutti i tipi di dati campione. Il campionamento stratificato è detto anche campionamento per tipo. La popolazione campione viene divisa in sottopopolazioni indipendenti tra loro. Il campionamento casuale è stato effettuato in proporzione a ciascuna sottopopolazione. Il campionamento stratificato consente di ottenere un campione più rappresentativo ed è più adatto a campioni sbilanciati.
Il diverso partizionamento dei set di dati può portare a diversi effetti del modello. Pertanto, in questo articolo si svolgono due gruppi di esperimenti secondo una diversa divisione del set di dati campione. Il primo gruppo ha diviso il set di dati in un set di addestramento e un set di test in un rapporto di 8: 2, mentre il secondo gruppo ha diviso il set di dati in un set di addestramento e un set di test in un rapporto di 7: 3. Osservare le prestazioni del modello di i quattro algoritmi con diverso partizionamento del set di dati.
3.1. Indicatori di valutazione. In questo studio, accuratezza, precisione, richiamo e punteggio F1- [26, 27] sono stati utilizzati per valutare l'effetto di previsione del modello. Considerando la particolarità della diagnosi medica, si prevede che tutti i tumori maligni della mammella possano essere previsti. Pertanto, il ricordo è qui considerato un importante indice di valutazione. Maggiore è il richiamo, maggiore è la percentuale di cancro al seno maligno che può essere prevista. I risultati della classificazione del modello possono generare una matrice di confusione [28], come mostrato nella Tabella 4
In questo caso, TP è un vero positivo, che indica il numero di campioni positivi previsti come campioni positivi. TN è un vero negativo, che indica il numero di campioni negativi previsti come campioni negativi. FP è un falso positivo, che indica il numero di campioni positivi previsti da campioni negativi, chiamato errore di tipo 1. FN è un falso negativo, che indica il numero di campioni positivi previsti come campioni negativi, chiamato errore di tipo 2
Precisione, abbreviata come P. Per i risultati previsti, la precisione rappresenta quanti dei campioni previsti positivi sono campioni positivi e la formula è:

3.2. Modello di previsione del cancro al seno basato su XGBoost. XGBoost, abbreviazione di extreme gradient boosting, è un algoritmo di potenziamento [29]. Sia XGBoost che la foresta casuale sono algoritmi di integrazione basati sull'albero decisionale. Diversamente dall'algoritmo Bagging, l'algoritmo Boosting costruisce gli studenti deboli uno per uno, accumulando più studenti deboli attraverso l'iterazione continua [30]. La funzione obiettivo è
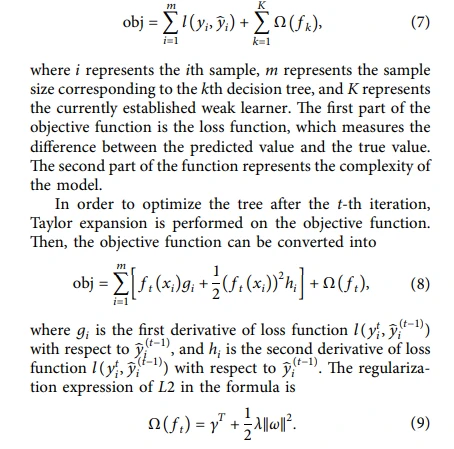
. (9) L'aggiunta di termini regolari può ridurre la varianza del modello e rendere più semplice il modello ottenuto dal training set, per prevenire il verificarsi di overting. L'algoritmo XGBoost viene utilizzato per addestrare il modello sul set di dati di addestramento. Nel processo di addestramento del modello, i parametri vengono adeguati per ottenere un insieme di parametri migliore e, infine, si ottiene il modello di previsione ottimale. Il modello è stato utilizzato per prevedere le categorie di cancro al seno in
collocamento. Quando il set di dati è stato diviso in un set di training e un set di test con un rapporto di 8: 2, l'accuratezza, la precisione, il ricordo e il punteggio F1- del modello XGBoost erano 0.974, {{5} }.960, 1.00 e 0.980, rispettivamente. Quando il modello XGBoost è stato diviso in un set di training e un set di test con un rapporto di 7:3, l'accuratezza, la precisione, il ricordo e il punteggio F1-del modello XGBoost erano 0.959, {{20} }.946, 0.991 e 0.968, rispettivamente. I risultati mostrano che il modello XGBoost ha prestazioni di previsione migliori quando il set di dati è diviso per 8: 2. Il tasso di richiamo di 1 indica che il modello XGBoost ha previsto correttamente tutti i tumori al seno maligni nel campione, il che è molto importante per il diametro medico
osi. 3.3. Modello di previsione del cancro al seno basato sulla foresta casuale. La foresta casuale è un algoritmo di apprendimento supervisionato che integra più alberi attraverso l'idea di Bagging [31–33]. Il metodo bootstrap viene utilizzato per estrarre il set di campioni di addestramento dai dati del campione originale e il modello di albero decisionale corrispondente viene addestrato per ciascun set di addestramento. Infine, vengono votati tutti i classificatori di base e quella con il maggior numero di voti costituisce la categoria finale.

cruento. Quando il set di dati è stato diviso in un set di training e un set di test con un rapporto di 8: 2, l'accuratezza, la precisione, il ricordo e il punteggio F1- del modello di foresta casuale erano 0.965, {{5 }}.947, 1.00 e 0.973, rispettivamente. Quando il set di dati è stato diviso in set di training e set di test con un rapporto di 7:3, accuratezza, precisione, richiamo e punteggio F1- erano 0.953, 0.946, { {18}}.981 e 0.963, rispettivamente. I risultati mostrano che il modello della foresta casuale ha prestazioni di previsione migliori quando il set di dati è diviso per 8: 2. Anche il tasso di richiamo di questo modello era 1, indicando che il modello della foresta casuale prevedeva correttamente anche tutti i seni maligni.
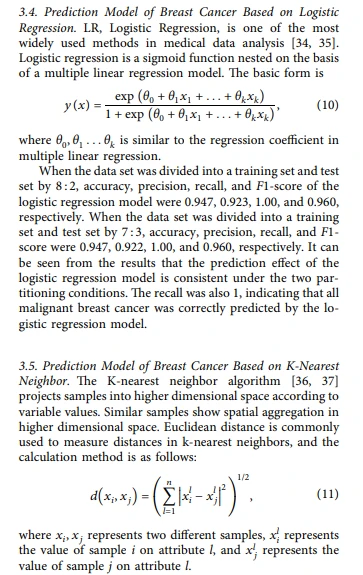
ma io. I tre elementi base dell'algoritmo k-vicino più vicino sono la misurazione della distanza, la selezione del valore k, la decisione di classificazione. I tre elementi base dell'algoritmo k-vicino più vicino sono la misurazione della distanza, la selezione del valore k e la regola decisionale di classificazione.
Per il problema della selezione del valore K nell'algoritmo del vicino più vicino k, questo articolo utilizza il metodo di validazione incrociata dieci volte (38, 39) e prende il tasso di richiamo come indice di valutazione del modello per selezionare un valore k appropriato. Lascia che l'intervallo di valori di k sia compreso tra 1 e 40 e per ogni k viene eseguita la convalida incrociata di dieci volte. Il valore k con la frequenza di richiamo massima è il valore k ottimale. Il richiamo di diversi valori k sotto la convalida incrociata di dieci volte è mostrato nella Figura 1.
Dalla Figura 1 si può vedere che all'aumentare del valore k, il richiamo diminuisce. Quando k=3 ek=5, il richiamo è maggiore. Poiché il valore k è impostato su un valore troppo basso, è facile sovrastimare, quindi il valore k qui è impostato su 5.
Quando il set di dati è stato diviso in un set di training e un set di test con un rapporto di 8: 2, l'accuratezza, la precisione, il ricordo e il punteggio F1- del modello k-vicino più vicino erano 0.912, { {6}}.888, 0.986 e {{10}}.934, rispettivamente. Quando il set di dati è stato diviso in set di training e set di test con un rapporto di 7:3, accuratezza, precisione, richiamo e punteggio F1- erano 0.930, {{21} }.906, 0.991 e 0.946, rispettivamente. I risultati mostrano che il modello k-vicino più vicino ha prestazioni di previsione migliori quando il set di dati viene diviso per 7:3.
4. Confronto e analisi
Per comprendere meglio le prestazioni del modello stabilito in questo documento, questo documento si basa sull'ambiente di sviluppo Python 3.9.7 e utilizza i dati sul cancro al seno forniti dal Dr. William dell'Istituto di ricerca medica clinica dell'Università del Wisconsin per gli esperimenti.
L'ambiente sperimentale è il sistema operativo Windows 11, il processore è Intel(R) Core(TM) i5-1155G7@ 2,50 GHz 2,50 GHz e la memoria è 8,00 GB.
I parametri sperimentali di ciascun modello sono mostrati nella Tabella 5 e verranno eseguiti i seguenti tre risultati di analisi comparativa: (1) confronto delle prestazioni di ciascun modello in questo documento quando il set di dati è diviso in un set di addestramento e un set di test in 8 : 2. (2) Confronto delle prestazioni di ciascun modello in questo articolo quando il set di dati è diviso in un set di addestramento e un set di test in 7: 3. (3) Confronto con alcuni modelli in letteratura [11–14].
(1) Quando il set di dati è diviso in set di addestramento e set di test secondo un rapporto 8: 2, le prestazioni di ciascun modello sono mostrate nella Tabella 6.
Come si può vedere dalla Tabella 4, dividendo il set di training e il set di test in un rapporto di 8: 2, la precisione dei quattro metodi di machine learning è superiore a 0.9, tra cui XGBoost e RF sono superiori a { {5}}.95. La precisione della previsione di XGBoost è 0.974, indicando un'elevata precisione della previsione. Per precisione, la precisione del modello KNN non è elevata, inferiore a 0.9, solo 0.888. XGBoost ha la massima precisione, ovvero 0.960. Per quanto riguarda il richiamo, il richiamo di XGBoost, la foresta casuale e gli algoritmi di regressione logistica sono tutti 1. L'algoritmo k-nearest neighbor ha il richiamo più basso, ma è anche superiore a 0.95. Per questo studio, i tassi di richiamo rappresentano la percentuale di campioni di cancro al seno maligno che sono stati diagnosticati correttamente. In medicina, una malattia deve essere diagnosticata. La conseguenza della mancata diagnosi è il ritardo del trattamento, che può far sì che i pazienti non raggiungano il momento migliore per il trattamento. Questo è molto più grave che ricevere una diagnosi di malattia senza averne una. Pertanto, il tasso di richiamo è un indicatore molto importante nel campo della diagnosi delle malattie. In questo caso, il richiamo di XGBoost, la foresta casuale e l'algoritmo di regressione logistica sono tutti 1, indicando che tutti i tumori al seno maligni nei campioni sono stati diagnosticati. Per il punteggio F{{20}}, si può vedere che il punteggio F1-di XGBoost, foresta casuale e regressione logistica sono tutti superiori a 0.95. Il punteggio F1-dell'algoritmo XGBoost è il più alto, raggiungendo 0.980. Il modello del vicino più vicino K ha il punteggio F1-più basso pari a 0,934. Prendendo in considerazione i quattro indicatori, si può affermare che quando il set di dati è suddiviso in training set e test set con un rapporto di 8:2, l'effetto complessivo del modello dell'algoritmo XGBoost è migliore rispetto agli altri tre modelli. XGBoost non solo ha ottenuto un ricordo di 1, ma ha anche ottenuto un ricordo di 0,95 o più per gli altri tre parametri.
(2) Quando il set di dati è diviso in un set di addestramento e un set di test in 7: 3, le prestazioni di ciascun modello sono mostrate nella Tabella 7.
Come si può vedere dalla Tabella 7, quando il training set e il test set sono divisi per 7: 3, l'effetto del modello di XGBoost e RF non è buono quanto quello di 8: 2. Innanzitutto, in termini di indice importante ricordo, dividendo il set di dati per 8: 2, il ricordo di XGBoost e RF erano entrambi 1, ma ora sono diminuiti rispettivamente a 0.991 e {{10}}.981 . I due modelli sono leggermente diminuiti anche negli altri tre indici. Tuttavia, il cambiamento nell’effetto di previsione della regressione logistica e del modello del vicino più vicino K è diverso da questi due algoritmi. Per il modello di regressione logistica, i quattro indicatori sono cambiati appena quando il set di addestramento e il set di test sono stati divisi rispettivamente per 7:3 e 8:2. Ciò dimostra che il modello di regressione logistica non è quasi influenzato dalle diverse partizioni del set di dati. Nel caso di una suddivisione 7:3 tra il set di training e il set di test, la regressione logistica ha mostrato accuratezza, precisione e punteggio F1- inferiori rispetto a XGBoost e foresta casuale. Tuttavia, il richiamo del modello di regressione logistica è 1, indicando che sono stati previsti tutti i tumori maligni al seno, il che è di grande importanza per la diagnosi della malattia. Pertanto, si può affermare che l’effetto di previsione del modello di regressione logistica è migliore rispetto agli altri tre algoritmi. Per il modello KNN, quando il set di addestramento e il set di test sono stati divisi per 7:3, tutti e quattro gli indici sono aumentati. Il ricordo è aumentato a 0.991, che era superiore a quello della foresta casuale. L'accuratezza, la precisione e il punteggio F1- sono aumentati da 0.912, {{30}}.887 e 0.934 a 0 0,930, 0,906 e 0,946, rispettivamente. Pertanto, il modello KNN ha prestazioni migliori nel caso del set di addestramento e set di test diviso per 7:3 rispetto al modello diviso per 8:2. L'analisi mostra che la divisione dei set di dati non è fissa. Per modelli diversi, divisioni diverse apportano cambiamenti diversi nell’effetto di previsione del modello.
(3) Secondo l'analisi comparativa delle Tabelle 6 e 7, il modello XGBoost stabilito in questo documento (dividendo il set di addestramento e il set di test per 8: 2) ha l'effetto migliore, e quanto segue lo confronta con le prestazioni del modello nel letteratura [11-14] e i risultati specifici sono mostrati nella Tabella 8.
Come si può vedere dalla Tabella 8, i modelli con le migliori prestazioni dei cinque modelli sono il modello di regressione logistica della letteratura [13] e il modello XGBoost stabilito in questo articolo. Il richiamo e l'accuratezza del modello in letteratura [13] sono rispettivamente 0.99 e 0.98, mentre il richiamo e l'accuratezza del modello in questo documento sono 1.{{8} } e 0.974, rispettivamente, rispetto alla letteratura [13], il richiamo del modello è elevato e il richiamo nella diagnosi medica indica la probabilità di rilevare cellule tumorali, il che è di grande importanza per la classificazione delle cellule del cancro al seno, quindi il modello XGBoost stabilito in questo documento ha un migliore effetto di previsione e può essere utilizzato come strumento medico per aiutare i medici a elaborare piani di trattamento per i pazienti affetti da cancro al seno.

5. conclusione
Questo articolo ha previsto principalmente le categorie di cancro al seno, dalla preelaborazione dei dati alla selezione delle caratteristiche, e quindi alla creazione del modello. Infine, i risultati della previsione sono stati confrontati e analizzati sotto molti aspetti.
In questo articolo, il ricordo è considerato un indice importante per prevedere i campioni di cancro al seno maligno nel modo più accurato possibile. Il set di dati originale conteneva 30 caratteristiche e 15 caratteristiche sono state selezionate come input del modello attraverso il test di correlazione di Pearson. Prima della costruzione del modello, i dati venivano standardizzati per eliminare l’impatto delle diverse dimensioni sugli effetti del modello. Per il problema dei campioni positivi e negativi sbilanciati, il metodo di campionamento stratificato viene utilizzato per estrarre set di addestramento e set di test proporzionalmente in base a diverse categorie di dati. Quando si seleziona il valore k ottimale nel vicino k più vicino, il richiamo viene utilizzato come indice di valutazione del modello, in modo che il valore k con il tasso di richiamo più alto sia il valore ottimale.
I modelli vengono confrontati e analizzati sotto tre aspetti. I risultati sono mostrati come segue:
petti. I risultati sono mostrati come segue: (1) Nel caso di divisione del set di addestramento e del set di test per 8: 2, il richiamo di XGBoost, foresta casuale e regressione logistica è 1, che può prevedere tutto il cancro al seno maligno K -il ricordo del vicino più vicino è leggermente inferiore a 0.986 rispetto agli altri tre modelli. Per quanto riguarda l'accuratezza della previsione, la precisione e il punteggio F1- del modello, i risultati del modello XGBoost sono migliori dei risultati della foresta casuale e della regressione logistica, che sono 0.974, {{1 0}}.96 e 0.98, rispettivamente, quindi il modello XGboost viene selezionato come modello di previsione finale nella condizione di divisione 8: 2 del set di addestramento e del set di test.
(2) Nel caso di divisione del training set e del test set a 7: 3, i valori dei quattro indicatori di valutazione per XGBoost e random forest sono diminuiti, mentre i valori dei quattro indicatori di valutazione per il modello K-nearest neighbor sono stati migliorato, ma per il richiamo, solo il richiamo del modello di regressione logistica era 1 e gli altri modelli erano superiori a 0.98, quindi l'effetto di previsione del modello della regressione logistica era il migliore e l'accuratezza e la precisione della previsione e il punteggio F1-della regressione logistica erano rispettivamente 0.947, {{10}}.922 e 0.96.

(3) Dagli esperimenti si può vedere che in diverse divisioni, l'effetto di previsione del modello presenta cambiamenti diversi. Confrontando i modelli ottimali nei due set di esperimenti diversi, si può vedere che l'accuratezza della previsione, la precisione e il punteggio F1-del modello XGBoost (che divide il set di training e il set di test per 8: 2) sono superiori a quelli del modello di regressione logistica (che divide il training set e il test set per 7:3) quando il richiamo è 1, quindi il modello XGBoost (che divide il training set e il test set per 8:2) funziona migliore nel modello stabilito in questo documento. Inoltre, rispetto ai modelli presenti in letteratura [11–14], il modello XGBoost stabilito in questo articolo ha un effetto migliore e può identificare con precisione le cellule maligne del cancro al seno. Tuttavia, questa ricerca è limitata a set di dati numerici e in futuro proveremo a utilizzare algoritmi di deep learning per applicare varie tecniche di estrazione delle caratteristiche ai dati di immagine (come le immagini a raggi X) per ottenere risultati di classificazione migliori.
Disponibilità dei dati
I dati che supportano i risultati di questo studio sono apertamente disponibili nell'UCI Machine Learning Repository all'indirizzo https:// archive.ics.uci.edu/ml/datasets/Breast+Cancer+Wisconsin+ %28Diagnostic%29.
Conflitto di interessi
Gli autori dichiarano di non avere conflitti di interessi.
Ringraziamenti
Questo lavoro è stato sostenuto dalla National Natural Science Foundation of China (concessione n. 61502156), dal progetto di insegnamento e ricerca del comitato educativo di Hubei (concessione n. 282) e dalla Fondazione di dottorato dell'Università di tecnologia di Hubei (concessione n. BSQD13051).
Riferimenti
[1] V. Fotedar, S. Fotedar, P. Takur, S. Vats, A. Negi e L. Chanderkant, "Conoscenza dei fattori di rischio del cancro al seno e metodi per la sua diagnosi precoce tra gli operatori sanitari di base a Shimla, Himachal Pradesh," Giornale di Educazione e Promozione della Salute, vol. 8, pag. 265, 2019.
[2] MS Simon, TA Hastert, A. Barac, et al., "Fattori di rischio cardiometabolico e sopravvivenza dopo il cancro nell'iniziativa per la salute delle donne", Cancer, vol. 127, n. 4, pagine 598–608, 2021.
[3] HF Pasha, RH Mohamed, MM Toam e AM Yehia, "Modificazioni genetiche ed epigenetiche del gene dell'adiponectina: p", The Journal of Gene Medicine, vol. 21, n. 10, pag. e3120, 2019.
[4] D. Hong, AJ Fritz, SK Zaidi, et al., "La transizione epiteliale-mesenchimale e le cellule staminali del cancro contribuiscono all'eterogeneità del cancro al seno", Journal of Cellular Physiology, vol. 233, n. 12, pagine 9136–9144, 2018.
[5] J. Zhong, D. Sun, W. Wei, et al., "Aspirazione con ago sottile guidata da ultrasuoni con contrasto per la biopsia del linfonodo sentinella nel cancro al seno in stadio iniziale", Ultrasound in Medicine and Biology, vol. . 44, n. 7, pagine 1371–1378, 2018.
[6] K. Babic, C. Siguan-Bell, M. Hee e SC Lin, "Oculare g: valutazione ecografica B-scan della spugna chirurgica trattenuta dopo intervento chirurgico alla valvola di Ahmed: un caso r," Journal of Glaucoma, vol. 26, n. 10, pp. e239–e241, 2017.
[7] A. Yala, PG Mikhael, F. Strand, et al., "Verso robusti modelli basati sulla mammografia per il rischio di cancro al seno", Science Translational Medicine, vol. 13, n. 578, articolo ID eaba4373, 2021.
[8] G. Zheng, X. Liu e G. Han, "Revisione del sistema di rilevamento e diagnosi assistita da computer di immagini mediche", Journal of Software, vol. 29, n. 5, pagine 1471–1514, 2018.
[9] EY Huang, S. Knight, CR Guetter, et al., "Telemedicina e telementoring nelle specialità chirurgiche: una revisione narrativa, The American Journal of Surgery, vol. 218, n. 4, pp. 760–766, 2019.
[10] Q. Wu, BT Wang, HR Rao, Y. Jiang e C. Liu, "Il cancro al seno e le cellule patologiche benigne formano la ricerca metrologica", Journal of Anhui Medical University, vol. 31, n. 02, pagine 91–93, 1996.
[11] Q. Shen, F. Shao e R. Sun, "Modello di previsione del cancro al seno basato su xgboost", Journal of Qingdao University (Natural Science Edition), vol. 32, n. 1, 2019.
[12] Z. Deng, B. Su e K. Zhan. g, "Classificazione del cancro al seno basata sull'apprendimento d'insieme", China Medical Devices, vol. 35, n. 12, 2020.
[13] M. Monirujjaman Khan, S. Islam, S. Sarkar, et al., "Analisi comparativa basata sull'apprendimento automatico per la previsione del cancro al seno", Journal of Healthcare Engineering, vol. 2022, ID articolo 4365855, 15 pagine, 2022.
[14] A. Bhardwaj, H. Bhardwaj, A. Sakalle, Z. Uddin, M. Sakalle e W. Ibrahim, "Analisi di algoritmi basati su alberi e apprendimento automatico per la classificazione del cancro al seno", Computational Intelligence and Neuroscience, vol. 2022, ID articolo 6715406, 6 pagine, 2022.
[15] H. Dong e L. Ma, "Modello di previsione del cancro al seno triplo negativo basato sull'apprendimento automatico", Journal of Yunnan University, vol. 39, n. 1, pagine 111–115, 2017.
For more information:1950477648nn@gmail.com


