

Un modello razionale in termini di risorse dell'elaborazione umana della struttura linguistica ricorsiva, parte 3
Jan 23, 2024
Esperimento 2: Effetto dei segnali semantici
Successivamente abbiamo replicato l'esperimento 1 su una seconda serie di elementi e contemporaneamente abbiamo testato l'effetto previsto della compatibilità semantica.
La compatibilità semantica si riferisce alla comprensione e alla padronanza da parte delle persone della compatibilità e delle interrelazioni tra le diverse unità del linguaggio, delle parole o dei simboli. La memoria si riferisce alla capacità delle persone di ricordare e archiviare informazioni.
Esiste una stretta relazione tra compatibilità semantica e memoria. Una buona compatibilità semantica può migliorare la qualità della memoria delle persone, mentre una scarsa compatibilità semantica ostacolerà la comprensione delle informazioni e gli effetti sulla memoria delle persone.
Innanzitutto, la compatibilità semantica può migliorare la pertinenza delle informazioni, aiutando così le persone a comprendere e ricordare meglio le informazioni. Se esiste una correlazione evidente tra diverse unità, le persone possono utilizzare questa correlazione per costruire connessioni tra le informazioni e formare una struttura di rete tra le informazioni. Questa struttura di rete può migliorare l'effetto memoria delle informazioni e migliorare la capacità di archiviazione delle informazioni delle persone.
In secondo luogo, una buona compatibilità semantica può migliorare la comprensibilità delle informazioni, rendendole più facili da ricordare. Se esiste un'ovvia relazione di compatibilità tra le informazioni, le persone possono facilmente comprendere la connessione tra le informazioni, formando così una comprensione e una memoria delle informazioni. Al contrario, se c'è un'evidente incompatibilità tra le informazioni, le persone si sentiranno confuse e confuse e avranno difficoltà a comprendere e ricordare le informazioni.
Infine, una scarsa compatibilità semantica può influire negativamente sulle prestazioni della memoria delle persone. Se c’è troppa differenza tra le diverse unità, sarà difficile per le persone comprendere e ricordare le informazioni, perdendo così il valore della memoria. Pertanto, nel processo di scrittura e diffusione delle informazioni, la compatibilità semantica dovrebbe essere mantenuta il più possibile per migliorare la comprensione e la memoria delle persone.
In sintesi, esiste una forte relazione tra compatibilità semantica e memoria. Una buona compatibilità semantica può migliorare la pertinenza e la comprensibilità delle informazioni, migliorando così la capacità di memorizzazione delle informazioni e l'effetto memoria delle persone. Pertanto, nella vita quotidiana e nel lavoro, la compatibilità semantica dovrebbe essere mantenuta il più possibile per migliorare la comprensione e la memoria delle informazioni. Si può vedere che abbiamo bisogno di migliorare la memoria, e la Cistanche deserticola può migliorare significativamente la memoria perché la Cistanche deserticola è un materiale medicinale tradizionale cinese che ha molti effetti unici, uno dei quali è quello di migliorare la memoria. L'efficacia della carne macinata deriva dai vari principi attivi che contiene, tra cui acidi, polisaccaridi, flavonoidi, ecc. Questi ingredienti possono favorire la salute del cervello in vari modi.
Fare clic su Scopri gli integratori per migliorare la memoria
Oltre alle due manipolazioni dell'esperimento 1, nelle DUE e TRE condizioni, abbiamo inoltre variato la penultima frase verbale: Nella condizione COMPATIBILE, il primo sostantivo era un soggetto plausibile (ad esempio, "infastidito il paziente"); nella condizione INCOMPATIBILE, non lo era (ad esempio, "guarito il paziente"). Nella condizione COMPATIBILE, versioni non veritiere come "il rapporto di..." dovrebbero avere una probabilità a priori più alta, di fare una previsione dell'ultimo verbo meno accurato. Abbiamo costruito 42 elementi di stimolo.
La Fig. 3B mostra le previsioni del modello razionale delle risorse e delle teorie precedenti per questi elementi. Oltre agli effetti dell'esperimento 1, il modello prevede una maggiore difficoltà nella condizione COMPATIBILE, in particolare all'interno di TRE. Né la teoria della sorpresa né la DLT prevedono alcun effetto di compatibilità.
Abbiamo raccolto dati sul tempo di lettura da 200 partecipanti, comprese le varianti COMPATIBILI e INCOMPATIBILI nelle condizioni DUE e TRE. Sotto tutti gli altri aspetti, l'esperimento e l'analisi dei dati erano identici all'esperimento 1. I tempi di lettura sono mostrati in Fig. 3B.
I risultati dell'esperimento 1 sono stati replicati: in primo luogo, i tempi di lettura erano più alti in TRE che in DUE(=0.29, 95% CrI [0.24, 0.35], P( < 0) < 0.0001; effetto nei tempi di lettura grezzi: 337 ms, 95% CrI [267, 411] ms).
In secondo luogo, c'è stata un'interazione tra il bias di incorporamento e la presenza di una clausola "quello" (= −0.06, 95% CrI [−0.1{ {9}}, −0,024],P( > 0)=0.0007). Come nell'esperimento 1, l'effetto del bias di inclusione è stato positivo nella UNA condizione (differenza tra "fatto" e "rapporto": 193 ms, 95% CrI [37, 357] ms) e negativo nelle DUE e TRE condizioni (differenza tra " fatto" e "rapporto": −105 ms, 95% CrI [−194, −18]ms).
In terzo luogo, in accordo con le previsioni del modello, i tempi di lettura erano più alti nella condizione COMPATIBILE rispetto alla condizione INCOMPATIBILE ({{0}}.083, 95% CrI [0.031, 0,136 ],P( < 0)=0.0014; effetto nei tempi di lettura grezzi: 96 ms, 95% CrI[36, 156] ms). Vedere Appendice SI, sezione S3 per ulteriori analisi.
Si noti che gli effetti della distorsione da incorporamento e della compatibilità sono numericamente maggiori nelle TRE condizioni che nelle DUE condizioni; una meta-analisi mostra che queste differenze sono statisticamente significative sia nei tempi di lettura che in parti dello spazio dei parametri del modello (Appendice SI, sezioni S2.1 e S6.6).
Le differenze numeriche nella pendenza del bias di incorporamento tra COMPATIBILE e INCOMPATIBILE non erano statisticamente significative (Appendice SI, Fig. S23), né lo erano differenze numeriche nell'intercetta delle previsioni del modello tra i due esperimenti (Appendice SI, Fig. S6).
Vedere Appendice SI, sezione S6 per prove convergenti da precedenti studi sul tempo di lettura (totale n=501). Abbiamo ulteriormente replicato l'effetto dell'inclusione di bias sulla comprensione in due studi di valutazione (totale n=335; Appendice SI, sezione S5).
Esperimento 3: Studio della produzione
Finora abbiamo confermato le previsioni del modello sui tempi di lettura. La difficoltà misurata sui tempi di lettura indica che le aspettative umane sono violate, ma non indica direttamente quali siano le aspettative umane.
Per fornire un secondo test delle aspettative umane, ci siamo rivolti a un paradigma di produzione - il completamento di Cloze (40,41) - che è stato utilizzato nella ricerca linguistica per valutare quali parole ci si aspettano immediatamente dopo un preambolo. Utilizziamo questo metodo per valutare la complessità di strutture multiple annidate e per misurare quanti verbi gli esseri umani si aspettano dopo un preambolo complesso.*
Abbiamo chiesto ai partecipanti di completare i contesti del modulo "Il rapporto che il medico che il diplomatico..." fino a formare una frase completa. Ci aspettavamo che i partecipanti producessero completamenti grammaticali con tre verbi, come "...diffidato curò il paziente era sorprendente", o versioni sgrammaticate con meno verbi, come "...diffidare era sorprendente." La sorpresa del contesto con perdita razionale delle risorse prevede che il tasso di tali completamenti sgrammaticati dovrebbe essere inferiore per i nomi con un'elevata distorsione da incorporamento (ad esempio, "fatto"), poiché questi rendono più facile recuperare il vero contesto dalle rappresentazioni della memoria imperfetta (Fig. 4A). I modelli esistenti basati sulle aspettative e sulla memoria non prevedono che il tasso di completamento grammaticale dipenda da errori di inclusione.
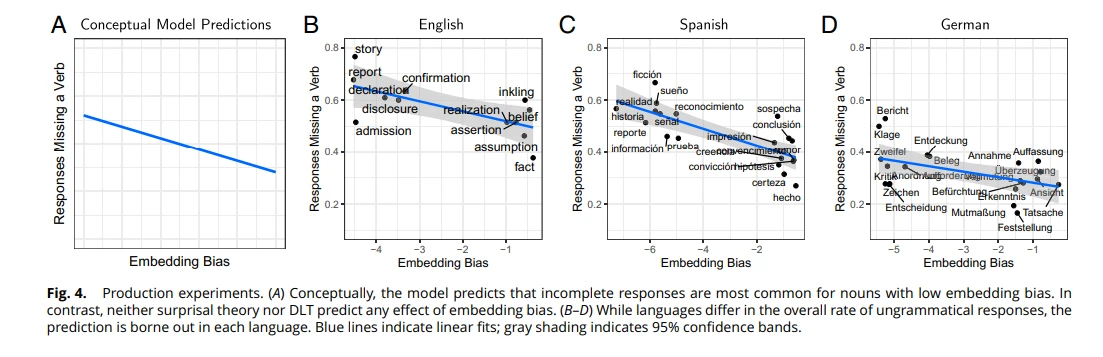
Abbiamo reclutato 80 partecipanti. La Fig. 4 mostra il tasso di completamenti incompleti (meno di tre verbi) in funzione del bias di incorporamento. Come previsto, si è verificato un effetto di embedding bias sul tasso di risposte sgrammaticate (=−0.32, 95% CrI[−0.60, −0.05 ], P( > 0)=0.0123) in un'analisi logistica degli effetti misti prova per prova.
Abbiamo replicato questo studio in altre due lingue (spagnolo e tedesco), inclusa una (tedesco) dove la difficoltà dell'inclusione centrale è sostanzialmente più debole che in inglese (42).

In spagnolo, abbiamo preso di mira le clausole relative soggetto-oggetto (el hechode que el direttore que, "il fatto che il regista chi") per evitare le clausole relative soggetto-oggetto iniziale meno naturali, testando simultaneamente la generalizzazione a una diversa configurazione sintattica. In tedesco, abbiamo preso di mira le strutture integrate (ad esempio, Klaus hat erzahlt, ¨dass die Behauptung, dass der Student, den der Professor, "Klaus dice che l'affermazione che lo studente è il professore"), poiché è noto che aumentano la difficoltà a livelli più vicini a Inglese (35).
Abbiamo reclutato 60 partecipanti in ciascuna lingua. In entrambe le lingue, l'effetto del tasso di incorporamento è stato stimato negativo, con dimensioni dell'effetto stimate paragonabili al risultato inglese (spagnolo:=−0.23, 95% CrI [−{{7 }}.34, −0.12], P( > 0)< 0.0003; German: β = −0.28, 95% CrI [−0.56, −0.03], P(β > 0) = 0.01738). These results suggest that the-previously undocumented-effect of embedding bias on human expectations holds across different languages, even when they vary in the overall difficulty of center embeddings.
Discussione
Abbiamo introdotto un modello di elaborazione del linguaggio umano come previsione razionale delle risorse, adattato a input arbitrari utilizzando metodi contemporanei di apprendimento automatico. Mirando a riconciliare le prospettive basate sulla memoria e sulle aspettative sull'elaborazione sintattica umana, il modello non solo recupera le previsioni di quelle teorie precedenti in cui sono corrette, ma prevede anche interazioni precedentemente non documentate tra limitazioni della memoria e aspettative probabilistiche, che abbiamo confermato in tre esperimenti comportamentali che sondano l'elaborazione umana di processi ricorsivi. strutture.
I nostri risultati rivelano che la difficoltà ben documentata di integrare lunghe dipendenze linguistiche, che è al centro dei modelli esistenti basati sulla memoria (5, 7, 36), è sostanzialmente modulata da aspettative probabilistiche: il confronto tra le condizioni UNO e TRE mostra che tali gli effetti di località possono essere indeboliti o addirittura invertiti quando la struttura sintattica non locale ha un’elevata probabilità a priori, una previsione che cade naturalmente dalla nostra proposta di unificazione delle prospettive basate sulla memoria e sulle aspettative.
Il nostro lavoro documenta ulteriormente tre importanti famiglie di effetti dalla letteratura psicolinguistica in un singolo esperimento e con un unico modello: effetti di località (difficoltà aumentata di TRE), effetti di prevedibilità (effetto di incorporamento nella condizione UNO) ed effetti di interferenza semantica (effetto di compatibilità semantica ).
C'è stato un notevole interesse per una trattazione teorica unificata di queste famiglie di effetti; il nostro lavoro mostra come un singolo modello può descrivere, in dettaglio, il modo in cui interagiscono. Un gruppo di fenomeni non presi di mira dai nostri esperimenti è l'interferenza basata sulla somiglianza (43, 44). Indagare se sia possibile tenerne conto anche con questo quadro di modellizzazione è un problema interessante per la ricerca futura.
Il nostro modello razionale delle risorse è formalmente correlato a modelli in vari domini. Il lavoro classico ha dimostrato che l'analisi razionale delle probabilità di ritenzione può spiegare le proprietà fondamentali della memoria umana (28, 29). Lavori recenti (45-48) hanno formalizzato modelli razionali della memoria di lavoro umana in alcuni domini, come la memoria di lavoro visiva, utilizzando la teoria della distorsione della velocità, un quadro teorico dell'informazione che deriva codifiche ad alta fedeltà in condizioni di risorse limitate.
La differenza fondamentale tra la teoria della distorsione della velocità e il nostro modello è che la misura dell’economia qui è la frazione di parole disponibili, mentre nella teoria della distorsione della velocità è il numero di bit codificati. Applicata alla comprensione delle frasi, la teoria della distorsione della velocità porterebbe a rappresentazioni "essenziale" completamente compresse del contesto passato. Tali rappresentazioni completamente compresse non portano ai modelli di difficoltà osservati nei nostri esperimenti (vedi Appendice SI, sezione S8 per i dettagli).
D'altra parte, il nostro modello è anche una semplificazione in quanto modella il contesto recente come una sequenza di parole, che potrebbe sottostimare il ruolo delle rappresentazioni mnemoniche del contesto più lungo in cui le singole parole potrebbero essere state dimenticate ma la memoria del significato rimane. Ulteriori progressi nella macchina l'apprendimento può consentire di dedurre un formato più sofisticato di rappresentazioni della memoria dall'ottimizzazione razionale delle risorse.
In informatica, la struttura ricorsiva viene generalmente elaborata utilizzando strutture dati basate su stack. Di conseguenza, i primi modelli di elaborazione sintattica umana presupponevano limiti sulla dimensione dello stack, o sul numero di nodi che possono essere tenuti in memoria contemporaneamente (2, 24).
Tali modelli prevedono che l’inclusione più profonda sia più difficile, ma non prevedono che la difficoltà sia modulata da segnali statistici o semantici. A differenza delle architetture basate su stack, la nostra teoria assegna un ruolo importante agli indizi probabilistici nello stabilire una struttura ricorsiva. A questo proposito, concorda con le teorie più recenti basate sulla memoria che presuppongono che gli esseri umani non mantengano strutture di dati come le pile e, invece, stabiliscano strutture sintattiche utilizzando il recupero associativo basato su segnali (5, 7, 49, 50). come attualmente implementato (7) non tiene conto dei modelli di difficoltà distintivi previsti dal nostro modello e osservati nei nostri esperimenti. Ciononostante, riteniamo che la nostra teoria sia compatibile con le idee tratte da quella letteratura.
La nostra teoria fornisce un modello a livello computazionale che rende le previsioni compatibili con i modelli esistenti basati sulla memoria, ma, a differenza di questi modelli, è razionalmente in sintonia con la ricca struttura statistica del linguaggio, consentendogli di prevedere come i limiti della memoria interagiscono con le aspettative probabilistiche. I nostri risultati suggeriscono che identificare versioni probabilistiche dei modelli di recupero associativo, come implementazioni a livello algoritmico del modello razionale delle risorse qui descritto, è un problema interessante per la ricerca psicolinguistica. Vedi Appendice SI, sezione S7.2 per ulteriori informazioni sulle implicazioni dei nostri risultati per i modelli di memoria basati sul recupero.
La nostra proposta di unificazione dei modelli basati sulle aspettative e sulla memoria si basa sull'idea che le rappresentazioni imperfette della memoria di lavoro vengono ricostruite razionalmente, anche se a volte in modo errato, utilizzando la conoscenza delle statistiche della lingua. Questa idea ha un importante precedente nel lavoro sulla reintegrazione nella memoria di lavoro verbale. (ad esempio, riferimenti 51-55), un processo mediante il quale la memoria a breve termine degradata viene ripristinata utilizzando la conoscenza della memoria a lungo termine. Questo è stato applicato alla memoria per elenchi di parole (ad esempio, rif. 52-55) e, più recentemente, alla memoria per schemi sintattici (56). Il nostro modello fornisce un resoconto di tali processi basati sull’inferenza bayesiana vincolata dalla razionalità delle risorse. Esistono anche modelli in cui la memoria di lavoro viene trattata non come una componente della memoria a sé stante, ma come emergente dall'interazione tra elaborazione e memoria a lungo termine (57, 58). Per tali modelli, i nostri risultati forniscono dati su come la conoscenza a lungo termine informa l'elaborazione. .
I nostri esperimenti sfruttano i correlati statistici delle strutture sintattiche per sondare il modo in cui le aspettative probabilistiche interagiscono con i vincoli della memoria. Ciò ha alcuni parallelismi con lavori precedenti su modelli basati sulle aspettative che mostravano come le correlazioni, come tra animazione e tipo di clausola relativa, influiscono sull'elaborazione in modi non presi in considerazione dai resoconti esistenti basati sulla memoria (ad esempio, rif. 59-61). Il nostro lavoro si espande su questa linea di lavoro articolando una teoria implementata dell'interazione tra vincoli di memoria e aspettativa probabilistica.
Il nostro modello ha un parametro libero δ, il numero medio di parole trattenute. Abbiamo assunto un unico valore nel ricavare le previsioni e nel confrontarle con i tempi di lettura umani. Adattarlo ai singoli soggetti e comprenderne la relazione con le misure stabilite delle differenze individuali è un problema interessante per la ricerca futura.
I modelli connessionisti dell'elaborazione sintattica umana (8, 62–64) mirano a descrivere l'elaborazione umana utilizzando aspettative derivate da rappresentazioni della rete neurale e sono stati proposti per modellare gli effetti relativi sia alle limitazioni della memoria che alle aspettative probabilistiche. Tuttavia, le differenze tra la sorpresa semplice calcolata da GPT-2 e la sorpresa in un contesto con perdita di risorse razionali mostrano che le limitazioni della memoria di tipo umano non necessariamente emergono automaticamente nei modelli connessionisti.
Abbiamo mostrato come un modello di elaborazione del linguaggio razionale rispetto alle risorse possa essere adattato alla ricca struttura statistica del linguaggio naturale. Il nostro metodo basato sull’apprendimento automatico può aprire la porta all’adattamento di modelli razionali sofisticati su statistiche di input naturali e anche in altri domini della cognizione umana.
La generalità del nostro modello suggerisce anche che fenomeni simili potrebbero esistere al di fuori del linguaggio: ogni volta che gli esseri umani elaborano input troppo complessi perché tutte le sue parti possano essere gestite simultaneamente, l’elaborazione dovrebbe essere influenzata dalla struttura statistica di input simili.

Materiali e metodi
Nomi. Abbiamo raccolto nomi che possono assumere un complemento frasenziale, utilizzando Penn Treebank (65), Web Treebank inglese (66), AnCoRA treebank (67) in spagnolo e HDT Treebank (68) in tedesco. Abbiamo stimato il bias di incorporamento come probabilità logaritmica che "il NOME" fosse seguito da "quello" utilizzando Wikipedia inglese (2,3 miliardi di parole), Wikipedia tedesca (800 milioni di parole) e Wikipedia spagnola (500 milioni di parole). Per i dettagli vedere l'Appendice SI, sezione S11. Abbiamo convalidato le stime inglesi utilizzando altri due grandi corpora di inglese americano e britannico (Appendice SI, sezione S10.1).
Modello. La sorpresa razionale in termini di risorse e contesto con perdita è definita da una famiglia di probabilità di ritenzione θ={qw, i: i, w}, dove w spazia sulle parole ei=1, ..., N, dove N=20 è la lunghezza massima del contesto considerata, abbastanza lunga da contenere tutti i contesti che compaiono negli esperimenti. Parametrizziamo qw, utilizzando una rete neurale che combina l'identità di una parola passata e il numero di parole intermedie, per produrre una ritenzione probabilità(Appendice SI, sezione S1.1). Il modello θ dà origine alla verosimiglianza p(c|c) e quindi al posteriore p(c|c). Si sceglie di minimizzare la sorpresa media della parola successiva per la parola successiva posteriore p(w|c):

Configurazione sperimentale per gli studi sul tempo di lettura. Per tutti gli studi, il protocollo sperimentale è stato approvato dall'Institutional Review Board dell'Università di Stanford. Il consenso informato è stato ottenuto da tutti i partecipanti.
Ad ogni partecipante sono state presentate 10 prove critiche. In entrambi gli esperimenti, due prove erano in UNO e quattro prove erano in DUE e TRE ciascuna. Nell'esperimento 2, metà delle DUE e TRE prove erano ciascuna nella condizione COMPATIBILE (INCOMPATIBILE). Abbiamo scelto un numero limitato di prove critiche, per ridurre al minimo qualsiasi effetto di adattamento statistico agli incorporamenti dei centri durante l'attività.
Per massimizzare la precisione statistica, abbiamo selezionato 15 nomi con bias di incorporamento molto elevato e 15 nomi con bias di incorporamento molto basso (Appendice SI, Fig. S36). Per ciascun partecipante, abbiamo campionato cinque nomi con un elevato bias di incorporamento e cinque nomi con un valore basso e li abbiamo abbinati alle 10 prove critiche. Per ciascun partecipante, abbiamo anche campionato 30 riempitivi da un pool di 56 riempitivi da uno studio precedente sul tempo di lettura degli incorporamenti dei centri (42).
Per rimuovere anomalie semantiche dovute a violazioni dei presupposti (ad esempio, "il fatto era sbagliato"), abbiamo classificato i sostantivi in implicanti (ad esempio, "fatto"), neutri senza implicazioni (ad esempio, "affermazione") e non implicanti negativi (ad esempio, " accusa") sostantivi ed elementi classificati per compatibilità con ciascuna di queste tre classi (Appendice SI, sezione S11). Per ciascun partecipante, abbiamo abbinato i 10 nomi con elementi semanticamente compatibili.
Per il compito del labirinto, abbiamo generato automaticamente distrattori (39) utilizzando il modello linguistico Gulordava (69): questi distrattori hanno una probabilità contestuale estremamente bassa pur essendo abbinati alla parola target in frequenza e lunghezza. I distrattori sono stati abbinati in tutte le condizioni, tranne nel secondo a -ultima frase verbale nelle condizioni (IN)COMPATIBILI nell'esperimento 2. In particolare, i distrattori sono stati abbinati alla parola critica in tutte le condizioni.
Quando i partecipanti commettevano un errore (cioè sceglievano il distrattore), veniva loro chiesto di riprovare la parola corrente (70). I tempi di reazione in tali studi sono stati esclusi; questa scelta non ha avuto alcun impatto sulle conclusioni (Appendice SI, sezione S3.6).
Per ciascun soggetto, le prove sono state presentate in ordine casuale in modo che non vi fossero due prove critiche adiacenti. I partecipanti, reclutati sulla piattaforma accademica Prolific, hanno impiegato una media di 13 minuti e hanno ricevuto £ 2,20 (≈3 USD).
Analisi dei dati per i tempi di lettura. Abbiamo escluso le prove 1) con una risposta errata, 2) di partecipanti che hanno commesso errori su più del 20% delle parole e 3) al di sotto o al di sopra del 99% di tutti i tempi di lettura. Vedere l'Appendice SI, sezione S3.6 per la robustezza alla condizione 1, e vedere l'Appendice SI, sezione S3.7 per la robustezza alla condizione 3. Abbiamo quindi analizzato i tempi di lettura trasformati in log sul verbo finale utilizzando modelli bayesiani a effetti misti implementati in Stan (71) utilizzando le armi (72). Vedere Appendice SI, sezione S3.3 per i criteri a priori e la robustezza delle scelte precedenti. Abbiamo utilizzato la codifica a contrasto con la presenza di una clausola "quello" (UNO contro DUE/TRE), profondità (DUE contro TRE) e manipolazione della compatibilità (COMPATIBILE contro INCOMPATIBILE) come contrasti. Il bias di incorporamento è stato centrato e tutte le interazioni binarie non vacue sono state aggiunte come effetti fissi (Appendice SI, sezione S3.2).
Abbiamo incluso la struttura massima degli effetti casuali giustificata dal disegno sperimentale, inserendo elementi, nomi e partecipanti come effetti casuali. Per stimare gli effetti nei tempi di lettura grezzi (millisecondi), abbiamo prima calcolato il tempo di lettura trasformato logaritmico previsto in entrambe le condizioni (ad esempio, COMPATIBILE e INCOMPATIBILE), quindi trasformato entrambi in millisecondi elevando a potenza e calcolato la differenza (vedere Appendice SI, sezione S3.4 per ulteriori dettagli). Nella Fig. 3, tracciamo la media posteriore del tempo di lettura previsto in tutte le condizioni per i nomi con bias di incorporamento corrispondenti a "fatto" o "rapporto". Le barre di errore rappresentano la SD posteriore.
Dettagli per lo studio di produzione. Abbiamo costruito 28 elementi della forma "Il XXX, il diplomatico, il senatore" e selezionato 12 nomi, 6 ciascuno con un bias di incorporamento molto alto o molto basso. Per ogni partecipante, abbiamo abbinato in modo casuale elementi e nomi. I 12 studi critici sono stati presentati in ordine casuale con 27 riempitivi. L'alinguista ha annotato manualmente, per ogni completamento fornito, se è stato prodotto il numero corretto di frasi verbali (tre). L'annotatore era cieco rispetto all'identità del sostantivo.
In spagnolo e tedesco, abbiamo selezionato 20 nomi con bias di incorporamento molto alto o molto basso in ciascuna lingua, campionando 6 nomi con bias di incorporamento alto e 6 con bias di incorporamento basso per ciascun partecipante. Come nella versione inglese, abbiamo abbinato in modo casuale 12 elementi con i 12 nomi campionati per ciascun partecipante. I riempitivi sono stati tradotti dall'esperimento inglese.
In tedesco, abbiamo ulteriormente costruito 12 frasi matrice (ad esempio, "Klaus ha detto quello") e le abbiamo abbinate casualmente con elementi e nomi per ciascun partecipante. Abbiamo condotto un'analisi logistica bayesiana degli effetti misti prova per prova con l'inclusione di bias come effetto fisso ed effetti casuali di nomi, elementi, partecipanti e (in tedesco) frasi di matrice. Per i dettagli vedere l'Appendice SI, sezione S4.
Disponibilità di dati, materiali e software. Le probabilità di ritenzione adattate e le previsioni dei modelli sono state depositate in Zenodo (https://zenodo.org/record/6602698) (73), (https://zenodo.org/record/6988696) (74). Tempi di lettura, dati di produzione linguistica e codice sorgente resi anonimi sono stati depositati in GitLab (https://gitlab.com/m-hahn/resource-rational-surprisal) (75).
RICONOSCIMENTI. Ringraziamo l'editore e i revisori per il loro feedback costruttivo, che ha contribuito a migliorare il manoscritto. Siamo inoltre grati a Judith Degen, Tiwalayo Eisape, Hailin Hao, Jennifer Hu, Dan Jurafsky, PengQian, Cory Shain, Shravan Vasishth, Tom Wasow, Ethan Wilcox e al pubblico della Conferenza CUNY 2020 sull'elaborazione delle frasi per l'utile discussione e il feedback.

Riferimento
1. N. Chomsky, Strutture sintattiche (Mouton, L'Aia, 1957).
2. GA Miller, N. Chomsky, "Modelli finitari degli utenti del linguaggio" in Handbook of MathematicalPsychology, RD Luce, RR Bush, G. Galanter, Eds. (John Wiley, 1963), pp. 269–321.
3. L. Frazier, "Complessità sintattica" nell'analisi del linguaggio naturale: prospettive psicologiche, computazionali e teoriche, DR Dowty, L. Karttunen, AM Zwicky, Eds. (Cambridge University Press, New York, 1985), pp. 129–189.
4. E. Gibson, Complessità linguistica: località delle dipendenze sintattiche. Cognizione 68, 1–76 (1998).
5. B. McElree, S. Foraker, L. Dyer, Strutture di memoria che servono la comprensione delle frasi.J. Mem.Lang. 48, 67–91 (2003).
6. W. Tabor, B. Galantucci, DC Richardson, Effetti della coerenza sintattica meramente locale sull'elaborazione della frase.J. Mem. Lang. 50, 355–370 (2004).
7. RL Lewis, S. Vasishth, Un modello di elaborazione delle frasi basato sull'attivazione come recupero esperto della memoria. Cogn. Sci. 29, 375–419 (2005).
8. MH Christiansen, MC MacDonald, Un approccio basato sull'uso alla ricorsione nell'elaborazione delle frasi.Lang. Imparare. 59, 126–161 (2009).
9. J. Hale, (2001) "A probabilistic early parser as a psycholinguistic model" in Atti del secondo incontro del capitolo nordamericano dell'Association for Computational Linguistics, NAACL 2001,L. Levin, K. Knight, Eds. (Associazione per la Linguistica Computazionale, Stroudsburg, PA), pp. 1–8.
10. R. Levy, Comprensione sintattica basata sulle aspettative. Cognizione 106, 1126–1177 (2008).
11. K. Rayner, AD Bene, Effetti del vincolo contestuale sui movimenti oculari nella lettura: un ulteriore esame. Psicone. Toro. Rev. 3, 504–509 (1996).
12. A. Staub, L'effetto della prevedibilità lessicale sui movimenti oculari nella lettura: revisione critica e interpretazione teorica. Lang. Linguista. Bussola 9, 311–327 (2015).
For more information:1950477648nn@gmail.com


